
Je vais faire votre web scraping et extraction de données avec un script Python
Sales 0


Sold by koatiromeo •Ingénieur IA, automatisation et cybersécurité (OSCP) · Agents IA, n8n, apps web et mobiles Total sales 0
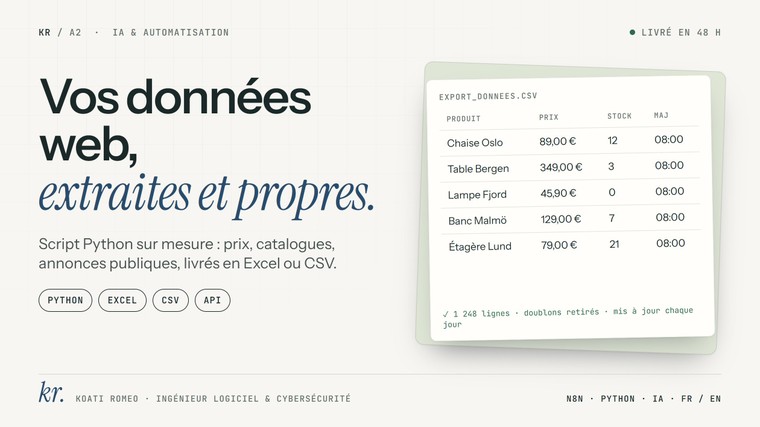
Vous avez besoin des données d'un site web dans un tableur. Une liste de produits avec leurs prix, un catalogue, des annonces, un annuaire d'entreprises, des horaires ou des fiches techniques. Les copier à la main prendrait des jours. Je fais le web scraping de ces données publiques avec un script Python et je vous livre un fichier propre, prêt à filtrer.
POUR QUI
- E-commerçants qui suivent les prix ou le catalogue d'un marché
- Analystes, étudiants et chercheurs qui ont besoin d'un jeu de données à partir de pages web publiques
- Entreprises qui veulent récupérer leurs propres données depuis un vieux site ou un outil sans export
- Toute personne qui a besoin d'une extraction de données ponctuelle ou régulière
CE QUE COMPREND L'OFFRE DE BASE ($28.01)
- L'extraction de données publiques sur 1 site, depuis une liste de pages ou une page de résultats
- Jusqu'à 1 000 lignes et 10 colonnes
- Un fichier propre en CSV, Excel ou JSON, au choix
- Le script Python source, avec une notice pour le relancer vous-même
- Un échantillon de contrôle avant l'extraction complète, pour valider les colonnes
- 2 retouches
DONNÉES PUBLIQUES UNIQUEMENT
J'extrais seulement des informations publiques et non personnelles (produits, prix, caractéristiques, contenus, données d'entreprises comme le nom ou l'adresse du siège). Je ne collecte jamais d'adresses email, de numéros de téléphone, ni de profils de personnes. Je ne contourne pas les pages protégées par un mot de passe ou un paywall. Je regarde aussi les conditions d'utilisation du site et son fichier robots.txt, et le script respecte un rythme de requêtes raisonnable. Si une demande sort de ce cadre, je vous le dis avant la commande.
COMMENT ÇA SE PASSE
1. Vous m'envoyez le lien du site et la liste des informations voulues. Je vérifie la faisabilité avant que vous commandiez.
2. Je vous envoie un échantillon de 20 lignes pour valider les colonnes et le format.
3. Je lance l'extraction complète, puis je nettoie le fichier (espaces, doublons évidents, formats de prix et de dates).
4. Je vous livre le fichier avec le script et sa notice. Vous validez, ou vous demandez une retouche.
CE QUE VOUS RECEVEZ
- Le fichier de données en CSV, Excel ou JSON
- Le script Python, commenté, que vous pouvez relancer quand vous voulez
- Une notice d'une page pour l'installer et l'exécuter
- Un court rapport sur ce qui a été extrait et les pages éventuellement ignorées
POURQUOI MOI
Je suis ingénieur logiciel, développeur freelance depuis 2019, avec un Master en génie logiciel et un Master en sécurité des systèmes d'information. Python est mon langage de tous les jours. Côté backend, j'utilise FastAPI et Django. J'ai construit un pipeline d'acquisition B2B qui repose sur du scraping, donc je connais les pièges classiques comme la pagination, les pages chargées en JavaScript ou les changements de structure. La plupart des offres de scraping livrent seulement un fichier. Moi, je vous laisse aussi le script, pour que vous ne dépendiez de personne la prochaine fois.
C'est une offre de lancement. Je n'ai pas encore d'avis sur ComeUp, alors je commence toujours par un échantillon validé avec vous.
LES OPTIONS EN BREF
- Si les données sont réparties sur plusieurs pages de résultats, l'option Pagination les parcourt toutes.
- Pour un site qui charge son contenu en JavaScript, il faut l'option Site dynamique (Playwright).
- Au-delà de 1 000 lignes, choisissez le palier de volume adapté.
- L'option Nettoyage et dédoublonnage met les données au propre pour un import direct.
- Avec l'option Google Sheets ou base de données, les lignes arrivent directement dans votre outil.
- L'exécution planifiée relance le script chaque jour ou chaque semaine pour une veille de prix ou de stock.
- Si vous avez déjà des fichiers Excel ou CSV à fusionner, nettoyer ou résumer, prenez l'option Traitement de fichiers.
Pour une collecte qui alimente ensuite un processus complet (CRM, rapports, alertes), voyez mon service Automatisation sur mesure d'un processus complet avec n8n, Python et IA.
QUESTIONS FRÉQUENTES
Pouvez-vous extraire n'importe quel site ?
La grande majorité des sites publics, oui. Je refuse les pages derrière une connexion ou un paywall, et les sites qui interdisent clairement l'extraction. Envoyez-moi le lien, je vous réponds avant la commande.
Est-ce légal ?
Extraire des données publiques et non personnelles, en respectant les conditions du site et un rythme de requêtes raisonnable, est en général admis. C'est pour cette raison que je me limite à ce cadre et que je vérifie chaque site avant de commencer.
Pouvez-vous récupérer des emails ou des numéros de téléphone ?
Non. Ce sont des données personnelles. Les collecter en masse sans l'accord des personnes pose un problème au regard du RGPD et des règles de ComeUp. Je peux en revanche extraire des données d'entreprises non personnelles, comme le nom, l'adresse du siège, le secteur ou le site web.
Quels formats de fichier ?
CSV, Excel ou JSON. Avec option, envoi direct dans Google Sheets ou une base de données.
Combien de lignes sont incluses ?
Jusqu'à 1 000 lignes et 10 colonnes dans l'offre de base. Des paliers existent jusqu'à 100 000 lignes.
Est-ce que je récupère le code ?
Oui, le script Python vous est livré avec une notice. Vous pouvez le relancer vous-même.
Que se passe-t-il si le site change de structure ?
Le script peut casser, c'est normal en scraping. L'option Maintenance 30 jours couvre ces corrections. Après, une petite commande suffit.
Pouvez-vous mettre à jour les données régulièrement ?
Oui, avec l'option Exécution planifiée, sur votre serveur ou votre ordinateur.
Le site affiche ses données en JavaScript. Est-ce possible ?
Oui, avec l'option Site dynamique, qui pilote un vrai navigateur avec Playwright.
Faites-vous aussi du traitement de données sans scraping ?
Oui. Fusionner plusieurs fichiers Excel, nettoyer une base ou produire un récapitulatif fait partie de l'option Traitement de fichiers.
Envoyez-moi un message ici avant de commander, je vous réponds en général en moins d'une heure.
