Je vais créer un dataset Q&A sourcé à partir de vos documents pour lIA et le RAG
 New
Sales 0

Sold by jamal3 •Python & Data | CSV, JSON, JSONL | Datasets Q&A | IA & RAG Total sales 0
VOUS AVEZ BESOIN D’UN DATASET Q&A SOURCÉ POUR VOTRE IA, VOTRE NLP OU VOTRE RAG ?
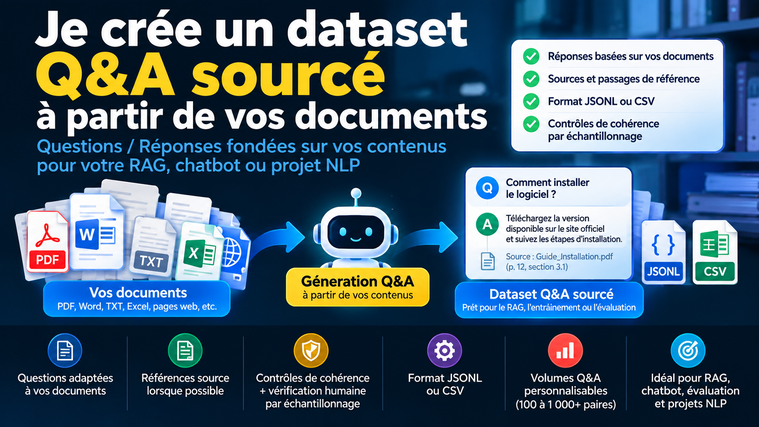
Je transforme vos documents en questions-réponses structurées et fondées sur leurs sources afin de créer un dataset Q&A exploitable pour l’évaluation RAG, les assistants IA, le NLP, la recherche documentaire ou d’autres workflows basés sur des LLM.
Le dataset peut être livré en JSONL ou CSV avec questions, réponses, identifiants, sources et métadonnées selon votre besoin.
SERVICE DE BASE — CRÉATION DE DATASET Q&A SOURCÉ
Je crée jusqu’à 100 paires Q&A à partir des documents que vous fournissez, avec réponses fondées sur le corpus et conservation de la provenance lorsque cela est possible.
Le service comprend :
- génération de questions à partir du corpus fourni
- réponses fondées uniquement sur les informations présentes dans les documents
- suppression des doublons évidents
- contrôles automatiques de cohérence
- vérification humaine par échantillonnage
- création d’un identifiant pour chaque paire
- conservation de la référence au document ou au passage source lorsque cela est possible
- validation de la structure JSONL ou CSV finale
- livraison en JSONL ou CSV
CE QUE VOUS RECEVEZ
Votre dataset Q&A pourra notamment contenir :
- question
- answer
- source ou référence au document
- identifiant unique
- métadonnées utiles selon votre besoin
- passage ou provenance associée lorsque cela est possible
Le dataset sera livré en JSONL ou CSV, avec une structure cohérente et exploitable pour un workflow RAG, NLP, LLM, évaluation IA ou recherche documentaire.
Si vous disposez déjà d’un schéma ou d’un exemple de sortie, je peux adapter la structure du dataset dans la limite de la prestation choisie.
QUALITÉ, TRAÇABILITÉ ET RÉPONSES SOURCÉES
Les questions et réponses sont générées à partir du corpus fourni.
Les réponses doivent rester cohérentes avec les documents source. Lorsqu’une information n’est pas suffisamment présente dans le corpus, l’objectif n’est pas d’inventer une réponse absente des sources.
Selon les documents disponibles, je peux conserver :
- la source ou le nom du document
- un identifiant de document
- une section ou référence
- un passage ou extrait associé
- des métadonnées utiles pour la traçabilité
Le dataset fait l’objet de contrôles automatisés de cohérence, de déduplication et de structure, ainsi que d’une vérification humaine par échantillonnage.
Cette prestation ne correspond pas à une relecture manuelle exhaustive de 100 % des paires Q&A.
Cette approche permet d’obtenir un dataset plus adapté aux usages de RAG, évaluation RAG, NLP, LLM et assistants IA.
PERSONNALISATION DES QUESTIONS — TYPE, NIVEAU ET PUBLIC CIBLE
Vous pouvez préciser notamment :
- le type de questions souhaité : factuelles, compréhension, raisonnement simple, FAQ, contrôle de connaissances, etc.
- le niveau de difficulté
- le public cible
- la langue
- les sujets, sections ou documents à privilégier
- les sujets ou contenus à exclure
- le format de sortie attendu
- le type de source ou de provenance à conserver
Selon votre besoin, je peux adapter le dataset pour un usage de RAG, évaluation RAG, NLP, LLM, chatbot, assistant IA ou recherche documentaire.
POUR DES VOLUMES PLUS IMPORTANTS
Des options permettent d’ajouter davantage de paires Q&A au service de base.
Les options sont cumulables : le nombre total livré correspond aux 100 paires du service de base auxquelles s’ajoutent les volumes supplémentaires sélectionnés.
Pour les corpus volumineux, plusieurs sources, des documents complexes ou des règles de génération spécifiques, contactez-moi avant de commander afin que nous validions le périmètre, le prix et le délai.
IMPORTANT AVANT DE COMMANDER
Merci de fournir des documents lisibles et exploitables et de préciser, si nécessaire :
- la langue souhaitée
- le type de questions recherché
- le niveau de difficulté
- le public cible
- les sujets à privilégier ou à exclure
- le format de sortie : JSONL ou CSV
- la provenance ou les références à conserver
- toute règle particulière de génération
Vous devez disposer des droits nécessaires pour utiliser et transmettre les documents fournis.
Pour les corpus très volumineux, hétérogènes ou difficiles à exploiter, contactez-moi avant commande afin de valider la faisabilité et le périmètre.