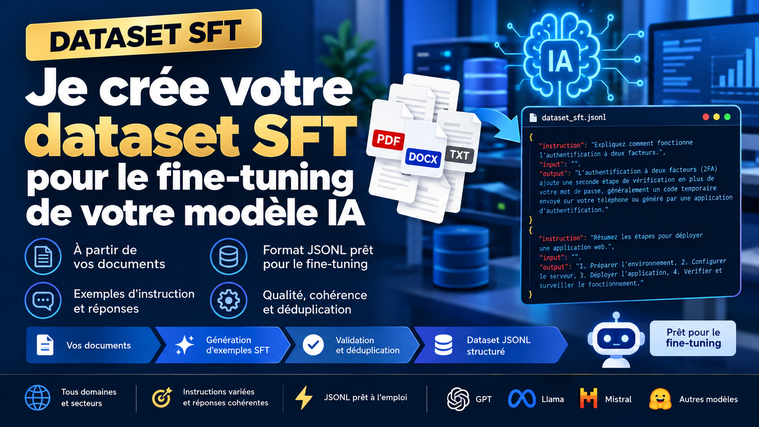
Je vais créer un dataset SFT pour le fine-tuning de votre modèle IA
 New
Sales 0

Sold by jamal3 •Python & Data | CSV, JSON, JSONL | Datasets Q&A | IA & RAG Total sales 0
VOUS AVEZ BESOIN D’UN DATASET SFT STRUCTURÉ POUR LE FINE-TUNING OU L’INSTRUCTION TUNING DE VOTRE LLM ?
Je transforme votre corpus en données d’entraînement structurées afin de créer un dataset SFT exploitable pour le fine-tuning, l’instruction tuning et d’autres workflows LLM.
Le dataset peut être livré en JSONL au format instruction/input/output ou messages user/assistant, avec identifiants et métadonnées selon votre besoin.
SERVICE DE BASE — CRÉATION DE DATASET SFT POUR FINE-TUNING
Je crée jusqu’à 100 exemples SFT à partir des contenus que vous fournissez, structurés pour un usage en fine-tuning, instruction tuning ou autre workflow LLM.
Le service comprend :
- génération d’instructions adaptées au corpus
- création des réponses correspondantes
- structuration des exemples
- suppression des doublons évidents
- diversification des formulations lorsque pertinent
- contrôles automatiques de cohérence
- vérification humaine par échantillonnage
- validation du fichier JSONL final
FORMATS SFT POSSIBLES — JSONL POUR LLM ET FINE-TUNING
Selon votre besoin, le dataset peut notamment être structuré sous forme :
- instruction / input / output
- messages avec rôles user / assistant
- structure JSONL personnalisée fournie par vos soins
- format compatible avec votre pipeline de fine-tuning ou d’instruction tuning
Si vous possédez déjà un schéma, un exemple ou quelques lignes du format attendu, je peux adapter la sortie à cette structure dans la limite de la prestation choisie.
QUALITÉ, COHÉRENCE ET CONTRÔLES DU DATASET SFT
Les exemples SFT sont générés à partir du corpus fourni et structurés de manière homogène.
Je veille notamment à :
- varier les formulations d’instructions lorsque pertinent
- conserver une cohérence entre instruction, input et output
- limiter les doublons évidents
- vérifier la validité du JSONL
- conserver une structure régulière sur l’ensemble du dataset
- effectuer des contrôles automatisés de cohérence
- réaliser une vérification humaine par échantillonnage
Lorsqu’une information nécessaire n’est pas suffisamment présente dans le corpus, l’objectif n’est pas d’inventer arbitrairement une réponse.
Cette prestation ne correspond pas à une relecture manuelle exhaustive de 100 % des exemples.
Le résultat est conçu pour être plus facilement exploitable dans un workflow de fine-tuning, instruction tuning ou préparation de données d’entraînement pour LLM.
CE QUE VOUS RECEVEZ
- un dataset SFT structuré au format JSONL
- des exemples cohérents pour fine-tuning ou instruction tuning
- une structure instruction / input / output ou messages user / assistant selon votre besoin
- des identifiants si nécessaire
- des métadonnées utiles selon le projet
- un contrôle de validité du fichier final
- un court récapitulatif de la structure utilisée
Le dataset est conçu pour être directement exploitable dans un pipeline de training data, fine-tuning, instruction tuning ou workflow LLM.
IMPORTANT AVANT DE COMMANDER
Merci de préciser :
- le type de documents ou corpus fourni
- la langue souhaitée
- le type de modèle ou workflow LLM visé, si vous le connaissez
- le format SFT attendu : instruction/input/output, messages user/assistant ou autre structure
- les sujets à privilégier ou à exclure
- les règles particulières concernant les instructions ou les réponses
- les identifiants ou métadonnées à conserver ou créer
- si possible, 1 à 3 exemples du format final attendu
Vous devez disposer des droits nécessaires pour utiliser et transmettre les contenus fournis.
Pour les corpus très volumineux, hétérogènes, difficiles à exploiter ou nécessitant un schéma spécifique, contactez-moi avant commande afin de valider la faisabilité.
Cette prestation concerne la création et la structuration d’un dataset SFT / training dataset pour LLM.
Elle n’inclut pas :
- l’entraînement ou le fine-tuning du modèle
- l’hébergement ou le déploiement du modèle
- la création complète d’une infrastructure RAG
- la création d’un dataset Q&A, disponible dans une prestation distincte